Links speichere ich im Alltag schnell nebenbei. Sie später wiederzufinden, ist eine andere Sache. Eien gute Suche ist wichtig. Ich mag aber auch gerne Tags haben um auch Zusammenhänge und ähnliche Links schneller zu sehen. Für meine selbst gehostete Linkding-Instanz habe ich deshalb einen Workflow gebaut, der neue und bisher unverschlagwortete Bookmarks automatisch einordnet.
Dabei kommen zwei Browser-Erweiterungen, die Linkding-REST-API, n8n und ein kleines Modell über Opper AI zusammen. Der entscheidende Teil ist nicht einfach „KI macht Tags“, sondern das Klassifikationssystem, nach dem die Tags vergeben werden.
Links im Browser sammeln und wiederfinden
Ich nutze zwei Erweiterungen, die unterschiedliche Aufgaben übernehmen:
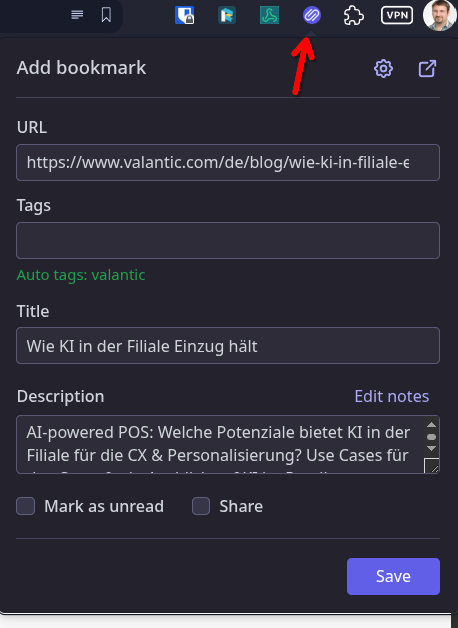
- LinkDing Extension (Chrome Store) speichert einen Link in meiner Linkding-Instanz. Zusätzlich blendet die Erweiterung Linkding-Suchergebnisse im Hintergrund auf Suchseiten wie Google ein. Ich kann also beim Suchen sehen, ob ein Link bereits in meiner Sammlung liegt.
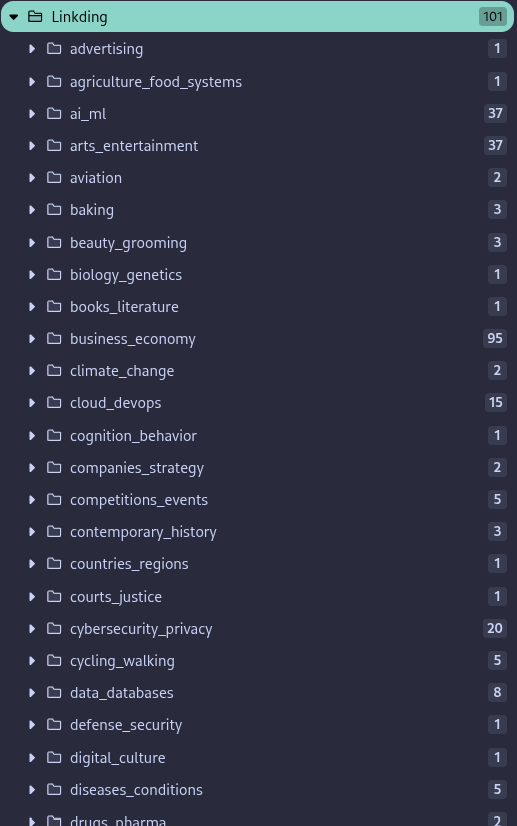
- LinkDing Bookmark Sync (Chrome Store) synchronisiert meine Tags als Ordner im Browser und ordnet die passenden Bookmarks darunter ein. So kann ich gespeicherte Links auch über die vertraute Ordnerstruktur wieder aufrufen.
Linkding läuft bei mir selbst gehostet. Für die Anmeldung nutze ich SSO über Authentik. Die Sammlung bleibt damit unter meiner Kontrolle, ist für mich aber auch über die Weboberfläche durchsuchbar.
Der n8n-Workflow übernimmt ungetaggte Bookmarks
Der Automatisierungsteil läuft in n8n. Über die Linkding-REST-Schnittstelle lese ich die Bookmarks aus, die noch keinen Tag haben. Damit bearbeitet der Workflow nicht bei jedem Lauf die komplette Sammlung erneut, sondern konzentriert sich auf die offenen Einträge.
Die Bookmark-Daten gebe ich an einen kleinen separaten n8n-Workflow weiter. Dessen Eingabeparameter heißt body und ist schlicht ein String. So bleibt der Baustein unabhängig vom ursprünglichen Ablauf: Er bekommt die Informationen zu einem Bookmark, klassifiziert sie und ermittelt am Ende eine Tag-Liste.
Für die Klassifikation verwende ich Opper AI als Model Router und das Modell kev 4b. Der Baustein ruft die API zweimal auf. Die Einordnung läuft in zwei Stufen und basiert auf einem Klassifikationssystem, das ich gemeinsam mit Gemini ausgearbeitet habe. Es ist eher eine Art Weltbild als eine lose Sammlung einzelner Themenwörter: Die Tags sollen Links in eine Struktur einordnen, die zu meiner Art passt, Wissen und Interessen zu sortieren.
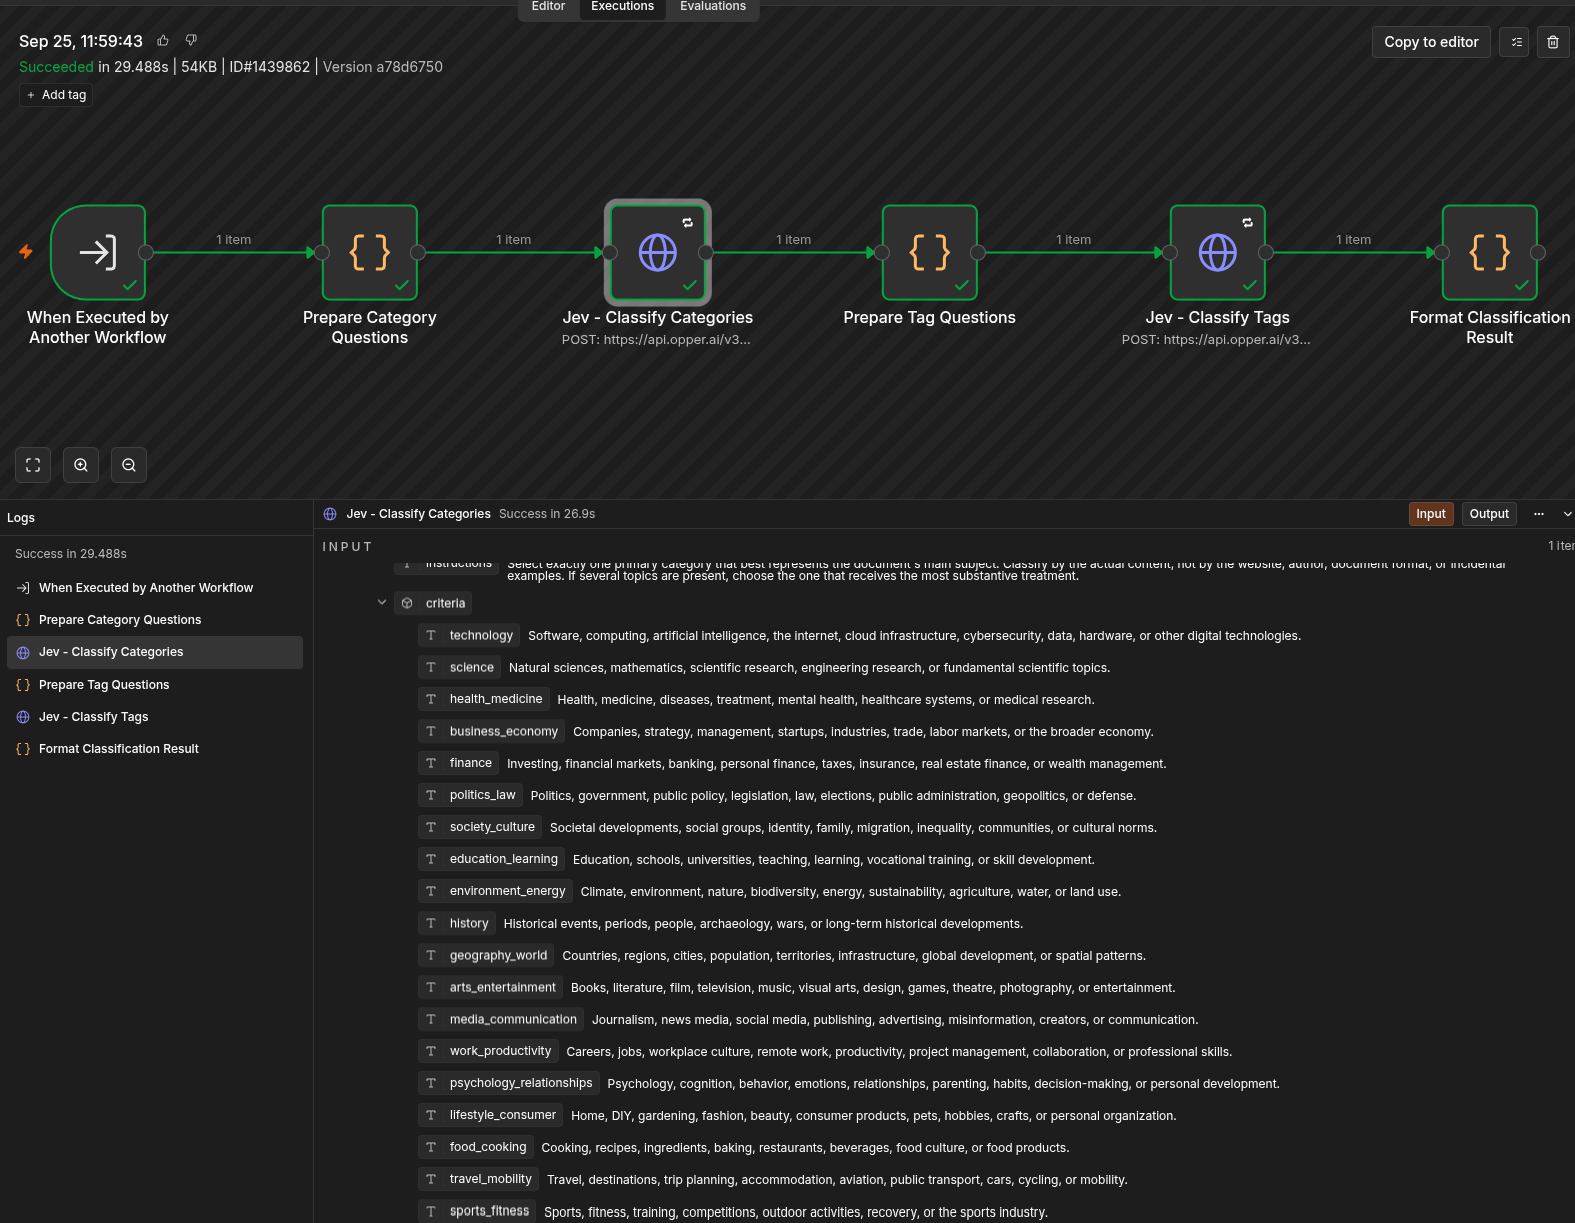
Ich beschreibe die beiden Schritte bewusst nicht als magische „KI versteht alles“-Funktion. Das Modell bekommt die Bookmark-Informationen und die Vorgaben des Klassifikationssystems; als Ergebnis liefert es die Tags, die ich für die Verschlagwortung nutze.
Warum ein kleines Modell hier ausreicht
Für diese Aufgabe brauche ich kein Modell, das lange argumentiert oder einen ausführlichen Text formuliert. Es soll einen Link anhand einer vorgegebenen Taxonomie schnell zuordnen. Das ist eine eng umrissene Klassifikationsaufgabe, bei der ein schnelles System-1-Modell für mich besser passt als ein großes Modell mit aufwendigem Reasoning.
Auch die Kosten sprechen dafür. Bei dem Tarif, den ich für kev 4b nutze, werden 0,04 US-Dollar pro einer Million Input-Tokens berechnet; Output-Tokens kosten nichts. Da der Workflow zweimal auf die API zugreift, ist der Input natürlich der relevante Kostenfaktor. Für die Menge an Text, die bei einem Bookmark anfällt, bleibt das sehr günstig. Die konkrete Preisangabe bezieht sich auf meinen verwendeten Tarif und kann sich ändern.
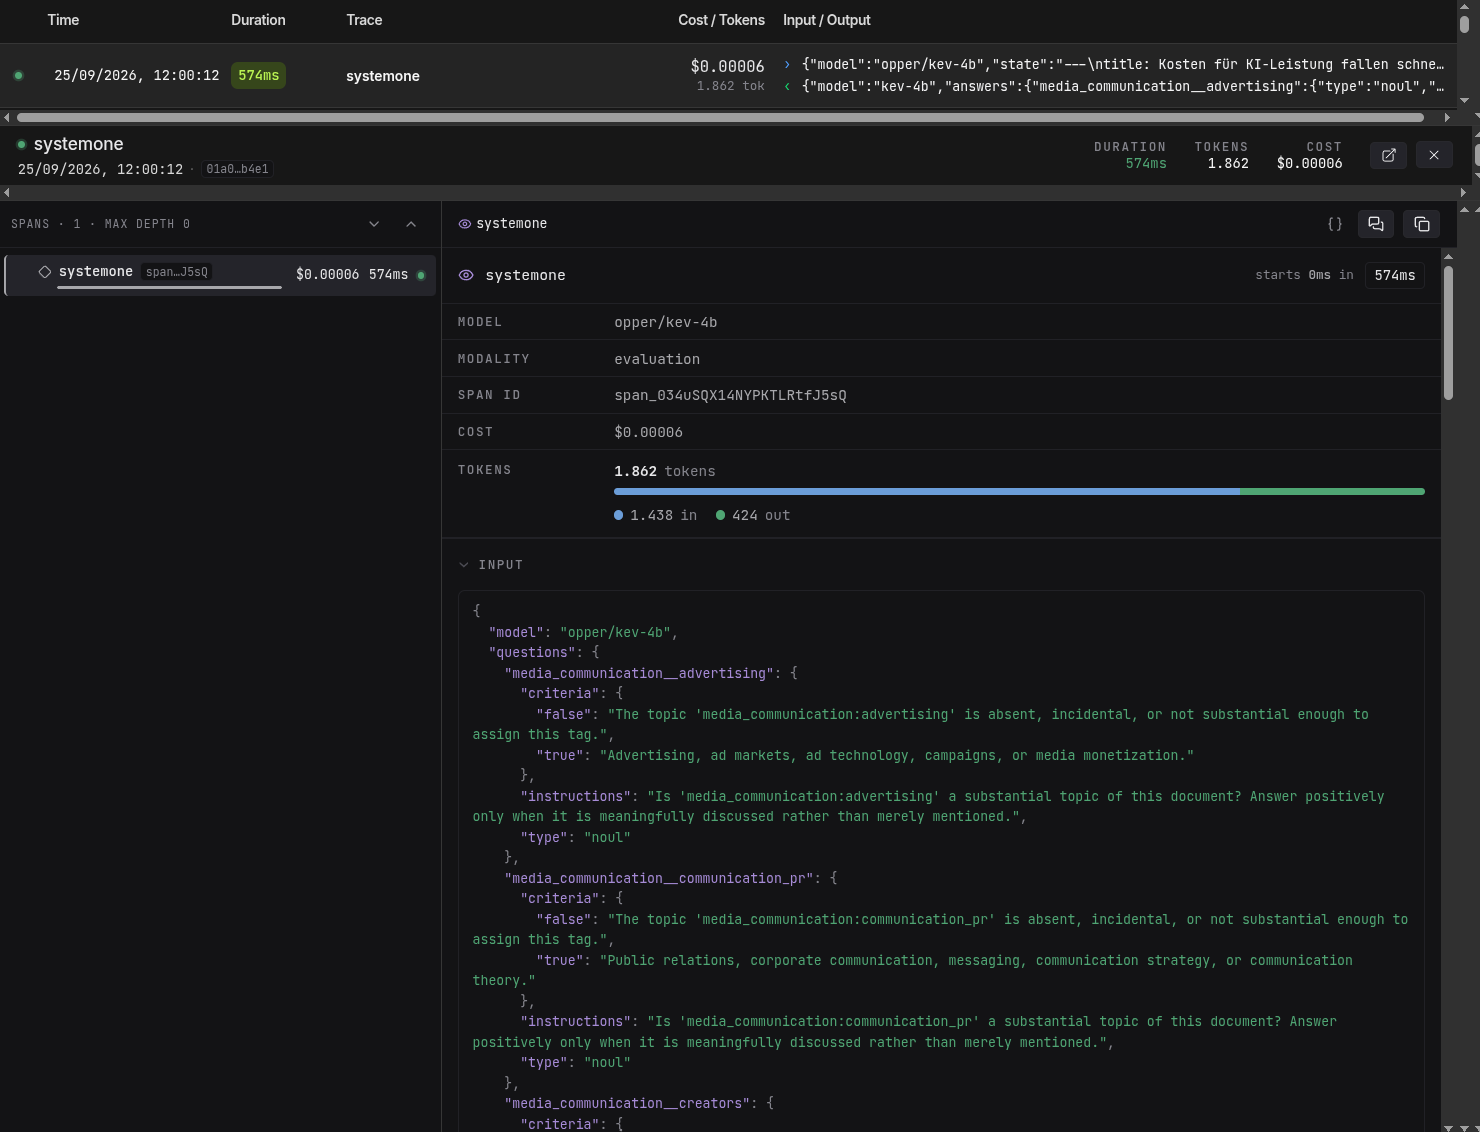
In der Praxis ist die Verarbeitung außerdem schnell genug, dass automatisches Tagging nicht zu einem eigenen Arbeitsschritt wird. Ein Link landet in Linkding, der Workflow klassifiziert ihn im Hintergrund, und die Tags stehen anschließend für Suche und Sync zur Verfügung.
Auch der vorhandene Bestand bekommt neue Tags
Der Workflow war nicht nur für neue Bookmarks nützlich. Ich habe damit auch alle meine bisherigen Bookmarks einmal neu taggen lassen. Das war wichtig, weil eine gute Taxonomie erst dann ihren Wert zeigt, wenn nicht nur die Links von heute, sondern auch das über Jahre gewachsene Archiv darin auftaucht.
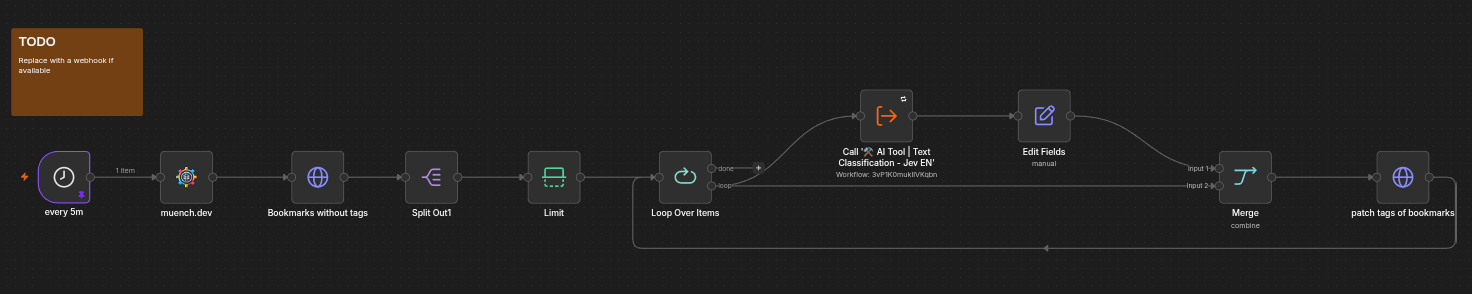
Seitdem (ok seit gestern erst) ist die Verschlagwortung für mich deutlich schneller und konsistenter. Dadurch, dass ich einfach alle Tags neu habe vergeben lassen, sehe ich deutlich den Unterschied zu vorher. Ich muss nicht jedes Mal neu überlegen, welchen Tag ich für einen ähnlichen Link verwendet habe. Und weil die Tags anschließend auch als Browser-Ordner sichtbar sind, funktioniert dieselbe Ordnung in Linkding und im Browser.
Was ich dabei im Blick behalten muss
Automatisches Tagging macht die Klassifikation nicht automatisch richtig. Wenn sich die Taxonomie verändert oder ein Bookmark mehrdeutig ist, kann ein Tag fehlen oder unpassend sein. Das System steht und fällt deshalb mit einer verständlichen, gepflegten Tag-Struktur. Die zwei Klassifikationsschritte ersetzen diese Arbeit nicht, sie wenden die Struktur nur konsequenter an.
Auch der Datenweg verdient Beachtung: Linkding ist selbst gehostet, aber die Bookmark-Informationen, die ich an den Klassifikationsbaustein übergebe, werden für die Modellverarbeitung an Opper AI weitergereicht. Self-Hosting allein bedeutet also nicht, dass jeder Verarbeitungsschritt lokal bleibt. Bei privaten oder vertraulichen Links muss ich berücksichtigen, welche Daten ich an den Router und das ausgewählte Modell sende.
Fazit
Der Workflow ist für mich ein gutes Beispiel dafür, wo ein kleines Modell sinnvoller sein kann als ein möglichst großes: Die Aufgabe ist klar begrenzt, die Tag-Struktur ist von mir vorgegeben, und das Ergebnis soll schnell und günstig verfügbar sein.
Mit Linkding als selbst gehostetem Archiv, den beiden Browser-Erweiterungen für Sammlung und Zugriff sowie n8n für die Automatisierung ist daraus ein Ablauf geworden, der neue und bestehende Bookmarks konsistenter sortiert. Der größte Aufwand lag nicht in den zwei API-Aufrufen, sondern darin, ein Klassifikationssystem zu entwickeln, das für meine Sammlung tatsächlich funktioniert.
Ich nutze noch zum sammeln für Artikel oder für ein "Read it Later" das Tool Readeck. Das kommt (bewusst) ohne KI-Tagging daher. Auch dort habe ich die gleiche Tagging-Logik integriert. Das ist aber was für einen gesonderten Blog-Artikel.